Уверенное объяснение потеряло букву.
Я спросил у 6 нейросетей, сколько «о» в слове «обороноспособность». Правильный ответ — 7. Получил 12 верных ответов из 18: даже такой счёт стоит проверять отдельно от качества текста.
Помните strawberry? В 2024 году ChatGPT насчитывал в нём две «r» вместо трёх. Я перенёс проверку на длинное русское слово. А самый показательный сбой случился у Grok: он объяснил свой ответ, предварительно изменив само слово. Почему просьба «проверь себя» может привести к такой подмене?
Три модели прошли проверку, ChatGPT ошибся во всех прогонах
В Услуги и цены, каждой модели достался одинаковый промпт на русском. Сделал по 3 прогона, ответы сохранил как есть. Весь тест обошёлся примерно в 0,37 ₽.
Ниже — ответы по порядку прогонов, число попаданий и средняя задержка ответа:
- Claude Opus 5.5 — 7/7/7; верно 3 из 3; 5,6 с.
- Gemini 4 Argon — 7/7/7; верно 3 из 3; 12,0 с.
- Qwen 3.8 Max — 7/7/7; верно 3 из 3; 17,9 с.
- Grok 4.7 — 7/6/7; верно 2 из 3; 39,9 с.
- DeepSeek V4 Pro — 7/6/6; верно 1 из 3; 1,9 с.
- ChatGPT (GPT-6 Astra) — 5/5/6; верно 0 из 3; 4,4 с.
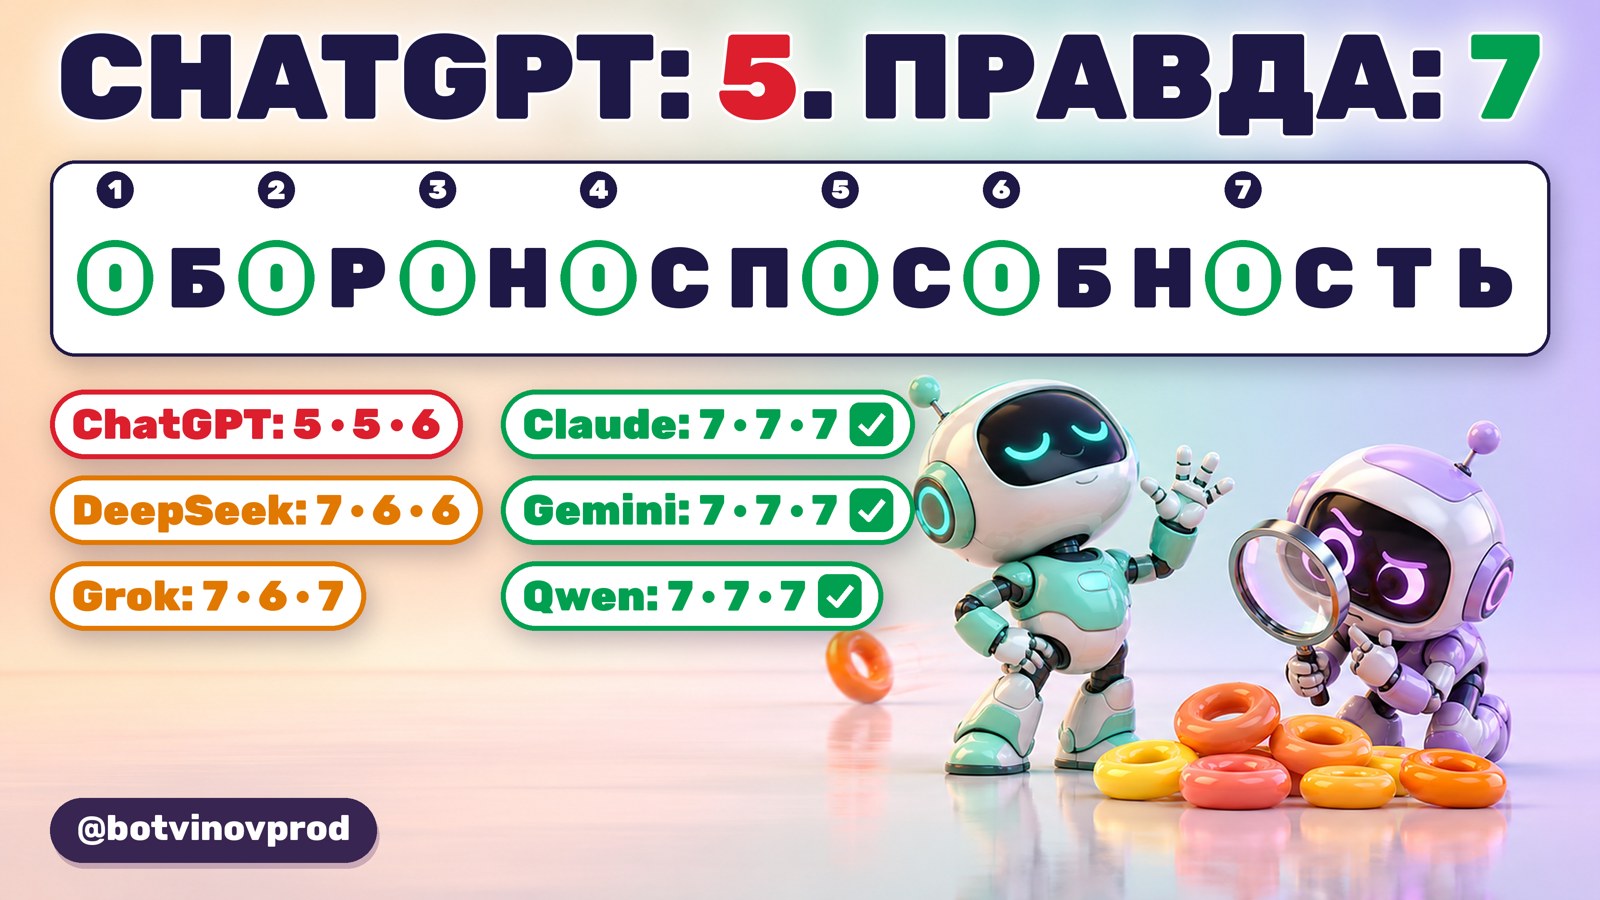
Повторяющаяся пятёрка у ChatGPT — полезная деталь. Стабильность ответа и его правильность — разные свойства. При повторном запросе можно получить ту же ошибку.
По скорости победителя тоже не выберешь: DeepSeek отвечал быстрее Claude, но чаще ошибался. У Grok была самая большая средняя задержка, и она тоже не обеспечила точный счёт. Статус флагмана здесь оказался таким же ненадёжным ориентиром.
Grok сначала подменил букву, затем обосновал ответ
Во втором прогоне Grok нарушил просьбу ответить только числом. Выдал 6 и добавил разбор по буквам. Внутри разбора «способность» превратилась в «спасобность»: модель утверждала, что после «п» стоит «а».
Цепочка видна прямо в ответе: исходное слово изменилось, одна «о» пропала, объяснение поддержало неверный счёт. Арифметика по изменённой строке уже не отвечает на исходный вопрос. Поэтому я сначала смотрю, что именно посчитали, и только потом проверяю сложение.
В третьем прогоне тот же Grok пошёл другим путём: «обороно» — 4, «способность» — 3, вместе 7. Разбиение помогло, когда части сохранились без искажений. Само наличие подробного объяснения ещё не означает, что исходник пережил проверку)
Токены не заменяют посимвольный счётчик
Модель получает текст кусками — токенами. Это могут быть части слова, целые слова или отдельные символы. Такой принцип обработки описан в документации OpenAI.
Длинное русское слово может распределиться между несколькими токенами. Границы этих кусков не обязаны совпадать с тем, как человек делит слово для подсчёта. Чтобы найти все «о», нужно дополнительно перебрать символы внутри кусков и сложить совпадения.
При обычном текстовом ответе модель может выдать правдоподобное число без надёжного выполнения этой операции. Получается ответ, похожий на результат счётчика, хотя отдельный счётчик мог вообще не запускаться. Если же сервис действительно выполняет код над исходной строкой, появляется отдельная операция, результат которой можно проверить.
На длинном русском слове это хорошо видно: из шести моделей три хотя бы раз ошиблись.
В работе подмена символа меняет данные, а не только стиль
Я делаю сайты и дизайн, поэтому смотрю на этот тест через обычную просьбу: «перепиши аккуратнее, данные сохрани». Текст может стать лучше, а важный фрагмент незаметно измениться.
В договоре или письме это имя и фамилия, в карточке товара — название компании или артикул. Здесь нельзя оценивать только то, насколько естественно читается фраза: нужно сохранить конкретное написание.
Телефон, ИНН и сумма требуют другой проверки: совпадают ли символы и их порядок с исходником. Правдоподобный набор цифр не заменяет исходные данные.
У копирайтера и маркетолога добавляется длина заголовка или метатега. Фраза «сократил до нужного количества знаков» — повод измерить получившуюся строку. А перед печатью проверяю уже финальный макет: если опечатка уйдёт в тираж флаеров, правки текста в чате будет мало.
Свой мини-тест можно провести за 5 минут
Для повторения нужен заранее известный правильный ответ. Иначе сравнивать будет не с чем.
- Отправьте исходный промпт без изменений: «Сколько раз буква «о» встречается в слове «обороноспособность»? Ответь одним числом.»
- Повторите запрос 3 раза для каждой выбранной модели. Для своего теста начинайте каждый прогон в новом чате, чтобы предыдущая попытка и ваши подсказки не влияли на следующую.
- Запишите ответы целиком. Если модель добавила объяснение, сохраните его вместе с числом: именно там может обнаружиться подмена.
- Сверьте ответы с эталоном. Отдельно отметьте, сохранила ли модель слово, выполнила ли формат ответа и правильно ли посчитала. Это разные проверки.
- Повторите на рабочем материале. Возьмите фрагмент, с которым собираетесь работать, и заранее определите, какие символы или данные должны сохраниться. Запишите дату и название выбранной модели.
Подсказку «разбей по буквам» лучше проверять отдельным запросом после исходного теста. Тогда будет видно, помогло ли изменение инструкции, а результаты разных условий не смешаются.
Перед отправкой я сверяю исходник, расчёт и финальный текст
Когда отдаю нейросети текст с именами и цифрами, прохожу такой чек-лист:
- Сохраняю оригинал рядом с ответом. Прошу менять формулировки, сохраняя имена, названия, артикулы и реквизиты. Сам оригинал оставляю доступным для сравнения.
- Прошу разложить спорный фрагмент на символы с номерами. Сверяю полученную последовательность с исходником, чтобы заметить пропуск, замену или перестановку.
- Делаю 2–3 прогона и сравниваю ответы. Расхождение сразу показывает участок, который требует внимания.
- Для точного количества запускаю счётчик. Длину строки проверяю обычным инструментом или функцией ДЛСТР в таблице. Для количества конкретной буквы вычитаю из длины исходника длину строки после удаления всех таких букв. Если модель умеет выполнять код, прошу написать и запустить расчёт на исходной строке; одного присланного кода недостаточно.
- Отдаю спорное место второй модели. Передаю исходник и критерий проверки, чтобы она проверяла материал самостоятельно, без готового чужого объяснения.
- Глазами сверяю финальные имена, телефоны и цифры. Делаю это в тексте, который пойдёт получателю или в публикацию, после всех правок.
У ДЛСТР есть важная граница: она считает всю строку, включая пробелы, а не вхождения выбранной буквы. Это описано в справке по подсчёту символов. Поэтому разность длин нужна именно для поиска повторений.
В автоматизации с ИИ я бы закреплял такие проверки отдельными шагами: сохранение исходных полей, сравнение значений, измерение длины. Тогда просьба модели «будь внимательнее» превращается в проверку с понятным условием прохождения.
Модель стоит выбирать под конкретную операцию
С Claude у меня получился переворот: в разборе Нейросети видят 8 рядов вместо 9 он ошибся 3 раза из 3, а здесь прошёл все попытки. Проверка структуры изображения и подсчёт букв требуют разных действий. Одно место в общем рейтинге эту разницу скрывает.
Для работы с изображениями у меня есть и другой разбор — Нейросети ошибаются на стрелочных часах. Выбирать проверку я бы начинал с того материала, который собираюсь отдавать модели.
Этот тест относится к одному слову и октябрю 2026 года; модели обновляются. Перед важной задачей стоит прогнать свой короткий набор примеров, а не переносить результат на любую работу с текстом.
Частые вопросы
Нужно ли считать «о» и «О» одинаково?
Это условие лучше задать заранее. Если нужен счёт без учёта регистра, сначала приведите текст к одному регистру в отдельной копии. Оригинал сохраняйте: для проверки написания имени заглавная буква тоже имеет значение.
Почему похожие буквы могут дать разный счёт?
Кириллическая «о» и латинская «o» — разные символы. В артикуле я сначала проверяю алфавит: внешнего сходства для точного поиска недостаточно. Такая сверка помогает отличить ошибку подсчёта от смешения символов в самой строке.
Посмотрите услуги и цены, чтобы выбрать подходящий состав работы.